
文本纠错
谷歌公司在2023年5月18日的产品更新中提出将会在桌面版的Chrome中添加一个新的功能:“检测地址栏中输入的URL拼写错误并根据更正建议网站”初步来看,目前这项技术是基于NLP领域的文本纠错模型实现的。下面简单介绍一下文本纠错模型。
一、引言
谷歌公司在2023年5月18日的产品更新中提出将会在桌面版的Chrome中添加一个新的功能:“检测地址栏中输入的URL拼写错误并根据更正建议网站”
初步来看,目前这项技术是基于NLP领域的文本纠错模型实现的。下面简单介绍一下文本纠错模型。
二、背景
2.1 需求
- 文本输入
由于用户在文本输入法,语音输入法使用上的随意性,后续又缺少审核,极易产生语法错误内容。近年来随着自媒体的热潮,人人都是信息的生产者,互联网上语法错误的内容暴增,有分析表明中文网络新闻标题和正文的语法错误率超过1%,这些语法不通顺的文本极大影响了用户体验。以输入“语法纠错方法调研”为例,可能产生的错误如下所示:
| 错误类型 | 错误句子示例(语法纠错方向调研) |
|---|---|
| 错字 | 愈发纠错方向调研 |
| 少字 | 语纠错方向调研 |
| 多字 | 语法发纠错方向调研 |
| 乱序 | 语法方向纠错调研 |
| 标点错误 | 语法纠,错方向调研 |
| 拼音 | 语法jiucuo方向调研 |
- 文本提示
2.2 常见产品
- 搜索引擎输入文本纠错:例如谷歌,百度等

- 文本编辑工具:例如微软的office,苹果的Pages等产品

方法上采用了经典的三步Pipeline:错误检测->候选召回->纠错排序
2.3 文本纠错的难点
三、技术发展
文本纠错的发展历史,大致分为以下三个阶段,分别是错别字字典,编辑距离和语言模型
如果从工程上看,一个完整的文本纠错流程应该分为以下四个步骤(以中文文本纠错为例):
3.1 基于字典的文本纠错技术
直接构建字典进行匹配,例如常见的office和Pages等产品,使用的自动纠错功能就是基于此方式。
优势在于速度比较快,实现起来比较简单。
缺点在于构建错别字词典人工成本较高,适用于错别字有限的部分垂直领域;并且错别字字典纠错的准确率较低。
3.2 基于距离的文本纠错技术
编辑距离(Levenshtein距离)算法由俄国科学家Levenshtein提出的,指的是两个字符串之间,由一个转换成另一个所需的最少编辑操作次数。许可的编辑操作包括将一个字符替换成另一个字符,插入一个字符,删除一个字符。
通过对照正确样本可以纠正部分常见错别字和语病,但是通用性不足。
算法流程如下
1、str1或str2的长度为0返回另一个字符串的长度。 if(str1.length0) return str2.length; if(str2.length0) return str1.length;
2、初始化(n+1)(m+1)的矩阵d,并让第一行和列的值从0开始增长。扫描两字符串(nm级的),如果:str1[i] == str2[j],用temp记录它,为0。否则temp记为1。然后在矩阵d[i,j]赋于d[i-1,j]+1 、d[i,j-1]+1、d[i-1,j-1]+temp三者的最小值。
3、扫描完后,返回矩阵的最后一个值d[n][m]即是它们的距离。关于编辑距离算法的详解可以看这篇文档
3.3 基于语言模型的文本纠错技术
使用序列标注模型进行文本纠错的出发点在于seq2seq生成文本的可控性较差,decode的推理速度也比较慢,在语法纠错的场景中,错误文本和正确文本的交集特别大,因此可以联系到字符串编辑距离的方式,如何通过较少的token编辑操作将错误文本改造成正确文本。
3.3.1 序列标注模型
- Parallel Iterative Edit Models for Local Sequence Transduction(EMNLP 2019)
比较早用tag方式做纠错的,他首先定义了copy, appends, deletes, replacements, ,case-changes这些编辑操作,比如下图的错误句子X和正确句子y,可以得出编辑方法e,然后对每个token打上标记。再使用迭代序列标注方法预测token-级别的编辑操作。
- Encode, Tag, Realize: High-Precision Text Editing(EMNLP 2019)
设置了两种标签keep和delete,然后在keep和delete的基础上添加额外标签P(表示在当前位置需要在前面加入短语P,P是空或单词或短语),如下图所示 。实验设置的词表V大小只有500(覆盖85%的训练数据),在实际应用场景可能会很大,所以整个预测空间是2V(V代表词表大小,2是keep或delete)。模型上在BERT的输出后添加MLP或transformer decoder进行序列标注。

- GECToR – Grammatical Error Correction: Tag, Not Rewrite(ACL 2020)
详细定义了多种语法操作的tag。tag空间达到了5000个,包括KEEP,DELETE,1167个依赖于token的append,3802个replace,和29个独立于token的语法变化(包括CASE:大小写,MERGE:将当前TOKEN和后面TOKEN合并成一个,SPLIT:将当前TOKEN拆成两个,单复数转换,时态转换等等)。因为语法纠错的数据都是wrong-correct pair,所以首先需要做的是预处理,对错误句子的每个token打上前面定义的tag,这部分需要较为复杂的处理,具体实现可以去论文里参考代码。 序列标注的数据生成好了,那么后面就很简单了,模型上就是基于bert的tagging模型,采用迭代序列标注的方法多轮tagging。这个方法是grammaly在conll数据上的sota,应该是和工业应用场景比较接近,基于tag方法的纠错就是需要这种细致的数据处理和tag定义。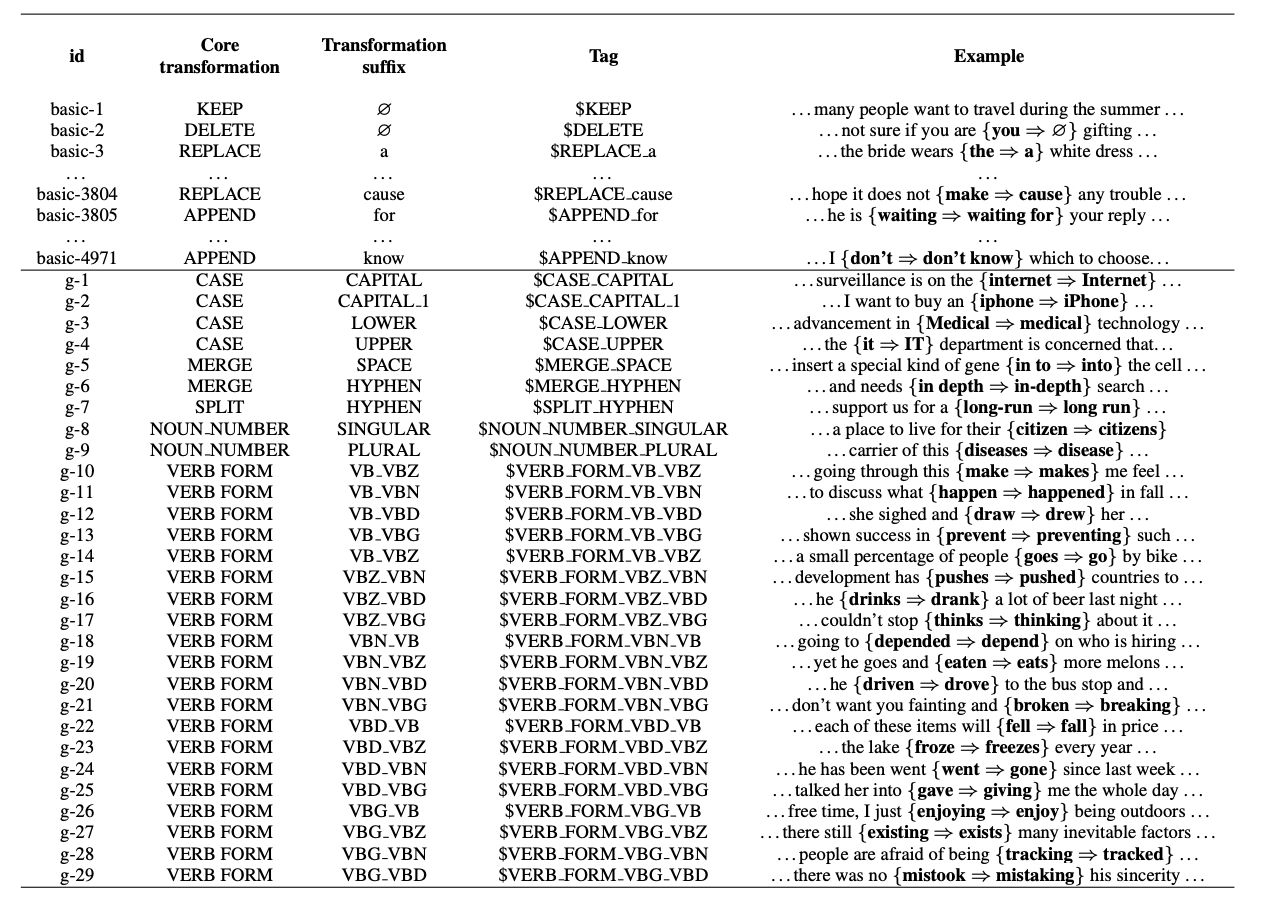
3.3.2 生成模型
语法纠错的目的是利用原句得到正确的句子,与机器翻译的任务很相似,所以将机器翻译的生成模型引入到语法纠错中取得了很好的效果。与机器翻译的区别是,target和source是同一种语言,且有很大的交集,也比较容易想到可以借鉴文本摘要中的Copy机制 。那么主要的研究方向包括,数据使用及训练策略,如何解决target和source交集过多的问题,解码策略。
- 训练策略
- Improving Grammatical Error Correction via Pre-Training a Copy-Augmented Architecture with Unlabeled Data(NAACL-2019)
基于去噪自编码方法在大规模数据上预训练,同时引入token级序列标注(判断这个token是否错误)和句子级别copy(判断改句子是否正确,正确就是应该全copy)做多任务提升copy机制在正确句子上的效果。
目前将bert引入到Encoder-Decoder中有两种方案,一种是使用bert进行encoder的初始化,但是seq2seq很容易会破坏预训练的表示,在大规模的seq2seq数据上会导致灾难遗忘。另一种是使用预训练表示作为额外特征, 然而预训练语言模型不会对输入数据和语法纠错任务泛化。《Encoder-Decoder Models Can Benefit from Pre-trained Masked Language Models in Grammatical Error Correction》先在检测数据上微调序列标注的BERT模型,然后使用Bert的输出和原始输入训练基于feature-based-Bert的Enc-Dec模型。主要动机是想如何把预训练bert的表示融入到enc-dec框架中
- copy 浪费效率
语法纠错的seq2seq大部分都在copy,所以这个地方的效率可以被优化。
- Improving the Efficiency of Grammatical Error Correction with Erroneous Span Detection and Correction(EMNL-2020)
利用序列标注01二分类来识别错误spans, 然后利用seq2seq模型进行纠错
- 解码策略
由于句子中可能会包含多次错误,一次生成可能无法全部改正,所以很多研究使用迭代解码策略。每一轮选择置信度高的候选作为下一轮的输入,一直解码直到输入无需纠正。
- Generating Diverse Corrections with Local Beam Search for Grammatical Error Correction(COLING-2020)
基于beam search的解码在语法纠错场景中提供的修改信息很少,很可能大部分都在复制。正如这个任务也不希望过多的对原句修改,因为非必要的修改会破坏输入句子中正确的部分。因此如何鼓励模型在必要的错误上尽可能的修改成为了关键。普通的beam search 会聚焦某个路径,只会修改特定相似的错误类型和错误token。而全局的多样性beam search会产生很多不同路径,然而也可以产生非正确的候选。该文章提出了diverse local beram search ,当一个token只有在需要修改时候,采用diverse beam search。