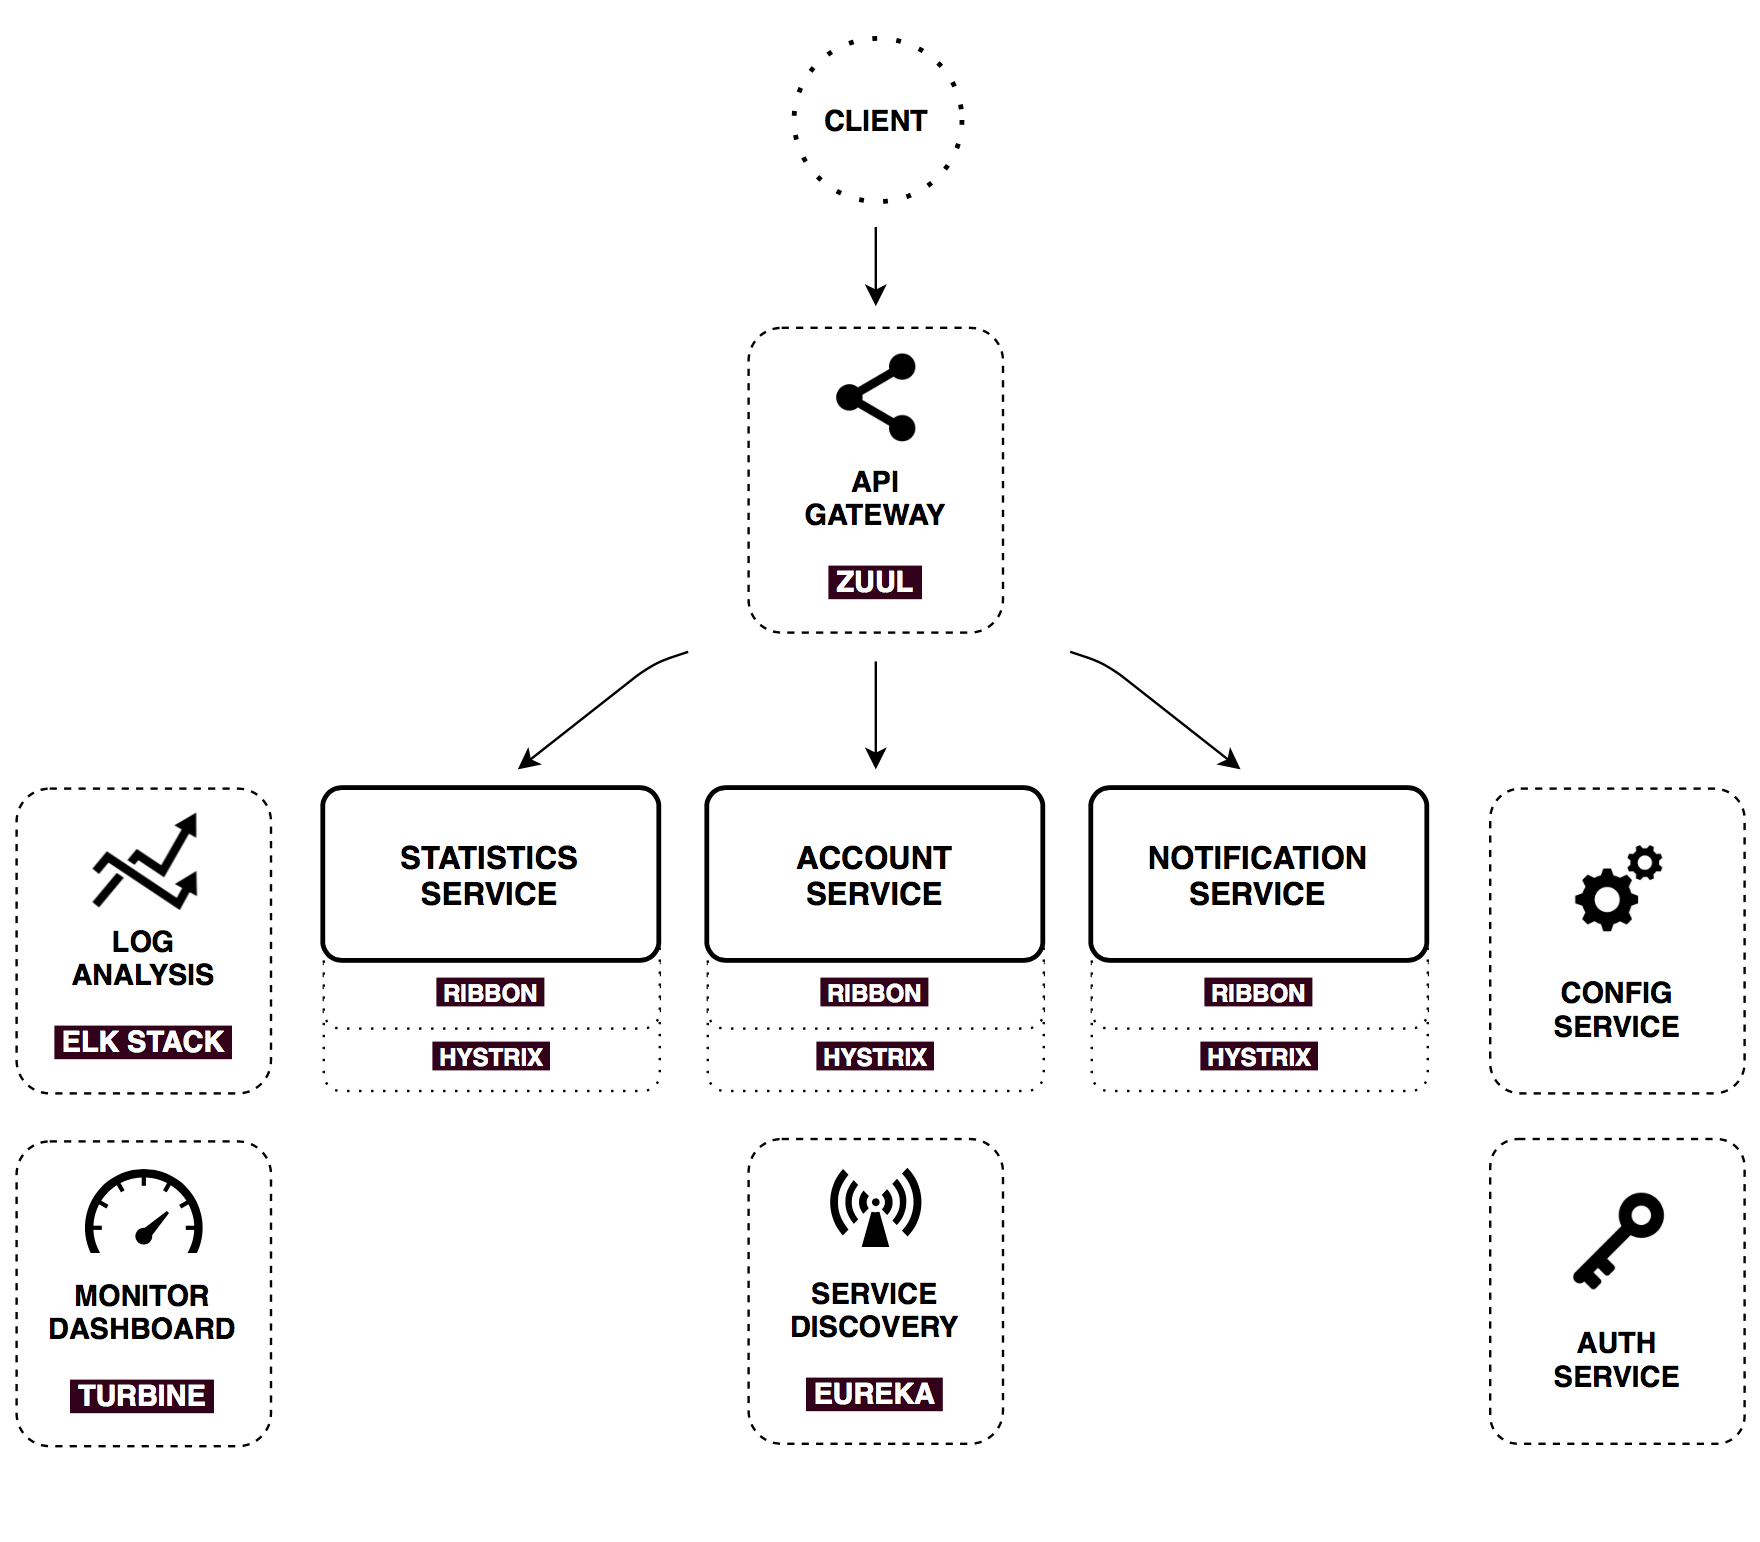
零、PiggyMetrics整体架构
前段时间在逛github的时候,发现了一个学习微服务的特别好的项目:piggymetrics, 项目整体是做一个个人理财记账的应用,但是使用到的技术栈还挺多,包含了Spring Boot, Spring Cloud and Docker等。深入理解一下这个项目对于提高自己的开发能力是有好处的。
前段时间在逛github的时候,发现了一个学习微服务的特别好的项目:piggymetrics, 项目整体是做一个个人理财记账的应用,但是使用到的技术栈还挺多,包含了Spring Boot, Spring Cloud and Docker等。深入理解一下这个项目对于提高自己的开发能力是有好处的。所以打算搞一个系列用于记录自己学习这个项目的过程。
这篇基本就是原项目的readme文档,我个人觉得写的挺清楚的,就简单翻译翻译吧。
1. 整体架构
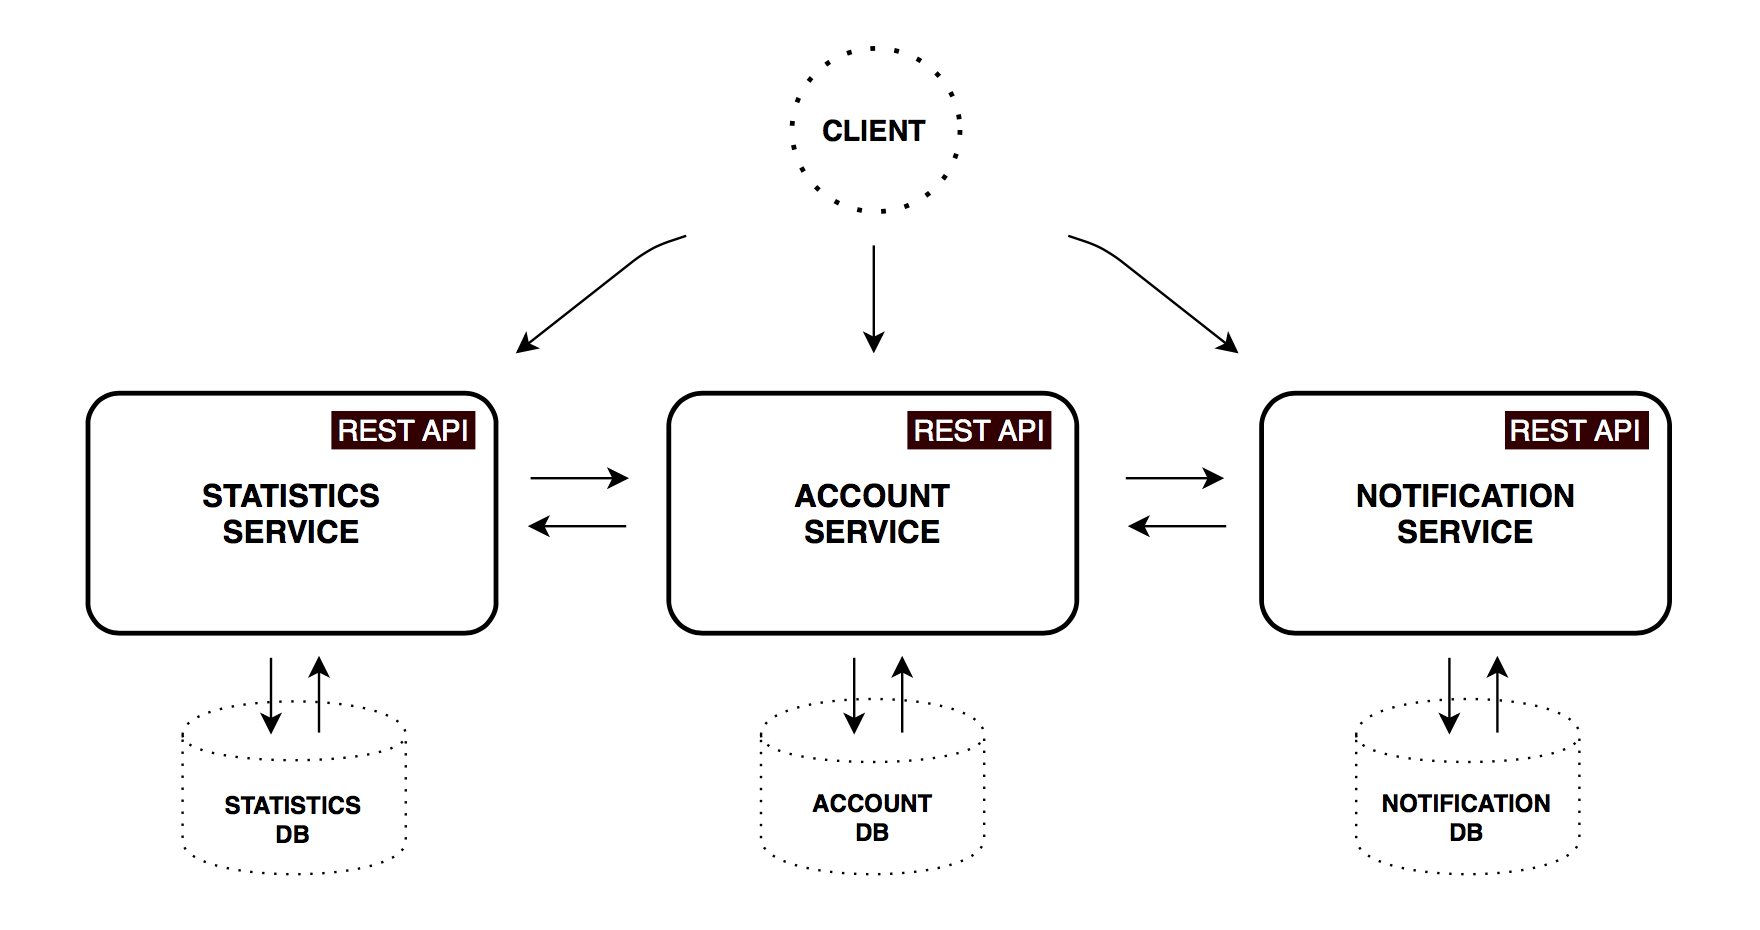
PiggyMetrics 被分解为三个核心微服务。 它们都是围绕特定业务领域组织的可独立部署的应用程序。他们分别是统计服务、账号服务和通知服务。
1.1 Account Service
包含常用的输入逻辑和验证逻辑:收入/支出项目、储蓄和账户设置等接口。
| Method | Path | Description | User authenticated | Available from UI |
|---|---|---|---|---|
| GET | /accounts/{account} | Get specified account data | ||
| GET | /accounts/current | Get current account data | × | × |
| GET | /accounts/demo | Get demo account data (pre-filled incomes/expenses items, etc) | × | |
| PUT | /accounts/current | Save current account data | × | × |
| POST | /accounts/ | Register new account | × |
1.2 Statistics service
对主要统计参数执行计算并捕获每个帐户的时间序列。 数据点包含标准化为基础货币和时间段的值。 此数据用于跟踪帐户生命周期内的现金流量动态。
| Method | Path | Description | User authenticated | Available from UI |
|---|---|---|---|---|
| GET | /statistics/{account} | Get specified account statistics | ||
| GET | /statistics/current | Get current account statistics | × | × |
| GET | /statistics/demo | Get demo account statistics | × | |
| PUT | /statistics/{account} | Create or update time series datapoint for specified account |
1.3 Notification service
存储用户联系信息和通知设置(提醒、备份频率等)。 预定工作人员从其他服务收集所需信息,并向订阅的客户发送电子邮件。
| Method | Path | Description | User authenticated | Available from UI |
|---|---|---|---|---|
| GET | /notifications/settings/current | Get current account notification settings | × | × |
| PUT | /notifications/settings/current | Save current account notification settings | × | × |
- 每个微服务都有自己的数据库,没有办法绕过API直接访问持久化数据。
- MongoDB 用作每个服务的主数据库。
- 所有服务都通过 Rest API 相互通信
2. 基础架构
Spring Cloud为开发者快速实现常见的分布式系统模式提供了强大的工具
2.1 Config Service
Spring Cloud Config 是分布式系统的水平可扩展集中式配置服务。 它使用当前支持本地存储、Git 和 svn的可插入存储库层。 在这个项目中,我们将使用本机配置文件,它只是从本地类路径加载配置文件。 在配置服务资源中可以看到共享目录。 现在,当 Notification-service 请求其配置时,Config 服务响应 shared/notification-service.yml 和 shared/application.yml(在所有客户端应用程序之间共享)。
2.1.1 client site usage
只需使用 spring-cloud-starter-config 依赖项构建 Spring Boot 应用程序,自动配置将完成其余工作。 现在您的应用程序中不需要任何嵌入式属性。 只需为 bootstrap.yml 提供应用程序名称和配置服务 url:
spring:
  application:
    name: notification-service
  cloud:
    config:
      uri: http://config:8888
      fail-fast: true
2.1.2 With Spring Cloud Config, you can change application config dynamically.
例如,EmailService bean 用@RefreshScope 注释。 这意味着您可以更改电子邮件文本和主题而无需重建和重新启动通知服务。 首先,在配置服务器中更改所需的属性。 然后对通知服务进行刷新调用:
curl -H "Authorization: Bearer #token#" -XPOST http://127.0.0.1:8000/notifications/refresh您还可以使用 Repository webhooks 来自动化这个过程。
- @RefreshScope 不适用于@Configuration 类并且不会忽略@Scheduled 方法
- fail-fast 属性意味着如果 Spring Boot 应用程序无法连接到配置服务,它将立即启动失败。
2.2 Auth Service
授权职责被提取到一个单独的服务器,该服务器为后端资源服务授予 OAuth2 令牌。 Auth Server 用于用户授权以及边界内的安全机器对机器通信。 在这个项目中,使用密码凭据授予类型进行用户授权(因为它仅由 UI 使用),并使用客户端凭据授予服务到服务的通信。 Spring Cloud Security 提供了方便的注解和自动配置,使其在服务器端和客户端都非常容易实现。 在客户端,一切都与传统的基于会话的授权完全相同。 您可以从请求中检索 Principal 对象,使用基于表达式的访问控制和 @PreAuthorize 注释检查用户角色。 每个 PiggyMetrics 客户端都有一个范围:用于后端服务的服务器和用于浏览器的 ui。 我们可以使用@PreAuthorize 注释来保护控制器免受外部访问:
@PreAuthorize("#oauth2.hasScope('server')")
@RequestMapping(value = "accounts/{name}", method = RequestMethod.GET)
public List<DataPoint> getStatisticsByAccountName(@PathVariable String name) {
	return statisticsService.findByAccountName(name);
}
2.3 API Gateway
API 网关是系统的单一入口点,用于处理请求并将它们路由到适当的后端服务,或者通过聚合分散-收集调用的结果。 此外,它还可用于身份验证、洞察力、压力和灰度测试、服务迁移、静态响应处理和主动流量管理。 Netflix 开源了这样的边缘服务,而 Spring Cloud 允许将其与单个 @EnableZuulProxy 注释一起使用。 在这个项目中,我们使用 Zuul 来存储一些静态内容(UI 应用程序)并将请求路由到适当的微服务。 下面是通知服务的一个简单的基于前缀的路由配置:
zuul:
  routes:
    notification-service:
        path: /notifications/**
        serviceId: notification-service
        stripPrefix: false
这意味着所有以 /notifications 开头的请求都将被路由到 Notification 服务。 如您所见,没有硬编码地址。 Zuul 使用服务发现机制来定位通知服务实例以及断路器和负载均衡器,如下所述。
2.4 Service Discovery
服务发现允许自动检测所有已注册服务的网络位置。 由于自动缩放、故障或升级,这些位置可能具有动态分配的地址。 服务发现的关键部分是注册中心。 在这个项目中,我们使用 Netflix Eureka。 Eureka 是客户端发现模式的一个很好的例子,其中客户端负责查找可用服务实例的位置并在它们之间进行负载平衡。 使用 Spring Boot,您可以使用 spring-cloud-starter-eureka-server 依赖项、@EnableEurekaServer 注释和简单的配置属性轻松构建 Eureka Registry。 使用 @EnableDiscoveryClient 注释启用的客户端支持带有应用程序名称的 bootstrap.yml:
spring:
  application:
    name: notification-service
该服务将注册到 Eureka Server,并提供主机、端口、健康指标 URL、主页等元数据。Eureka 从属于该服务的每个实例接收心跳消息。 如果心跳故障超过可配置的时间表,该实例将从注册表中删除。 此外,Eureka 提供了一个简单的界面,您可以在其中跟踪正在运行的服务和一些可用实例:http://localhost:8761
2.5 Load balancer, Circuit breaker and Http client
Circuit breaker 国内翻译成熔断器,是一种微服务架构的设计,参考这篇文章
熔断机制是应对雪崩效应的一种微服务链路保护机制。当链路的某个微服务出错不可用或者响应时间太长时,会进行服务的降级,进而熔断该节点微服务的调用,快速返回错误的响应信息。当检测到该节点微服务调用响应正常后,恢复调用链路。
2.5.1 Ribbon
Ribbon 是一个客户端负载均衡器,它使您可以对 HTTP 和 TCP 客户端的行为进行大量控制。 与传统的负载均衡器相比,不需要额外的网络跃点——您可以直接联系所需的服务。 开箱即用,它与 Spring Cloud 和 Service Discovery 原生集成。 Eureka Client 提供可用服务器的动态列表,因此 Ribbon 可以在它们之间进行平衡。
2.5.2 Hystrix
Hystrix 是断路器模式的实现,它使我们能够在与其他服务通信时控制延迟和网络故障。 主要思想是停止分布式环境中的级联故障——这有助于快速失败并尽快恢复——这是容错系统能够自我修复的重要方面。 此外,Hystrix 会为每个命令生成有关执行结果和延迟的指标,我们可以使用这些指标来监控系统的行为。
2.5.3 Feign
Feign 是一个声明式的 Http 客户端,它与 Ribbon 和 Hystrix 无缝集成。 实际上,单个 spring-cloud-starter-feign 依赖项和 @EnableFeignClients 注解为我们提供了一整套工具,包括 Load balancer、Circuit Breaker 和具有合理默认配置的 Http client。 下面是Feign的例子:
@FeignClient(name = "statistics-service")
public interface StatisticsServiceClient {

	@RequestMapping(method = RequestMethod.PUT, value = "/statistics/{accountName}", consumes = MediaType.APPLICATION_JSON_UTF8_VALUE)
	void updateStatistics(@PathVariable("accountName") String accountName, Account account);
}
- 您需要的一切只是一个界面
- 您可以在 Spring MVC 控制器和 Feign 方法之间共享 @RequestMapping 部分
- 上面的示例仅指定了一个所需的服务 ID - statistics-service,这要归功于通过 Eureka 的自动发现
2.6 Monitor dashboard
在此项目配置中,每个带有 Hystrix 的微服务都通过 Spring Cloud Bus(使用 AMQP 代理)将指标推送到 Turbine。 Monitoring 项目只是一个带有 Turbine 和 Hystrix Dashboard 的小型 Spring boot 应用程序。 让我们观察一下我们的系统在负载下的行为:统计服务在请求处理期间模仿延迟。 响应超时设置为 1 秒:
2.6.1 Log analysis
在尝试识别分布式环境中的问题时,集中式日志记录非常有用。 Elasticsearch、Logstash 和 Kibana 堆栈让您可以轻松搜索和分析日志、利用率和网络活动数据。
2.7 Distributed tracing
分析分布式系统中的问题可能很困难,尤其是试图跟踪从一个微服务传播到另一个微服务的请求。 Spring Cloud Sleuth 通过提供对分布式跟踪的支持解决了这个问题。 它向日志记录添加了两种类型的 ID:traceId 和 spanId。 spanId 表示一个基本的工作单元,例如发送 HTTP 请求。 traceId 包含一组形成树状结构的跨度。 例如,对于分布式大数据存储,跟踪可能由 PUT 请求形成。 对每个操作使用 traceId 和 spanId 我们知道我们的应用程序在处理请求时的时间和位置,从而使阅读日志变得更加容易。
Infrastructure automation
部署具有相互依赖性的微服务比部署单体应用程序复杂得多。 拥有完全自动化的基础架构非常重要。 我们可以通过持续交付方法实现以下好处:
- 随时发布软件的能力
- 任何构建最终都可能成为一个版本
- 一次构建工件 - 根据需要部署
这是一个简单的持续交付工作流,在这个项目中实现
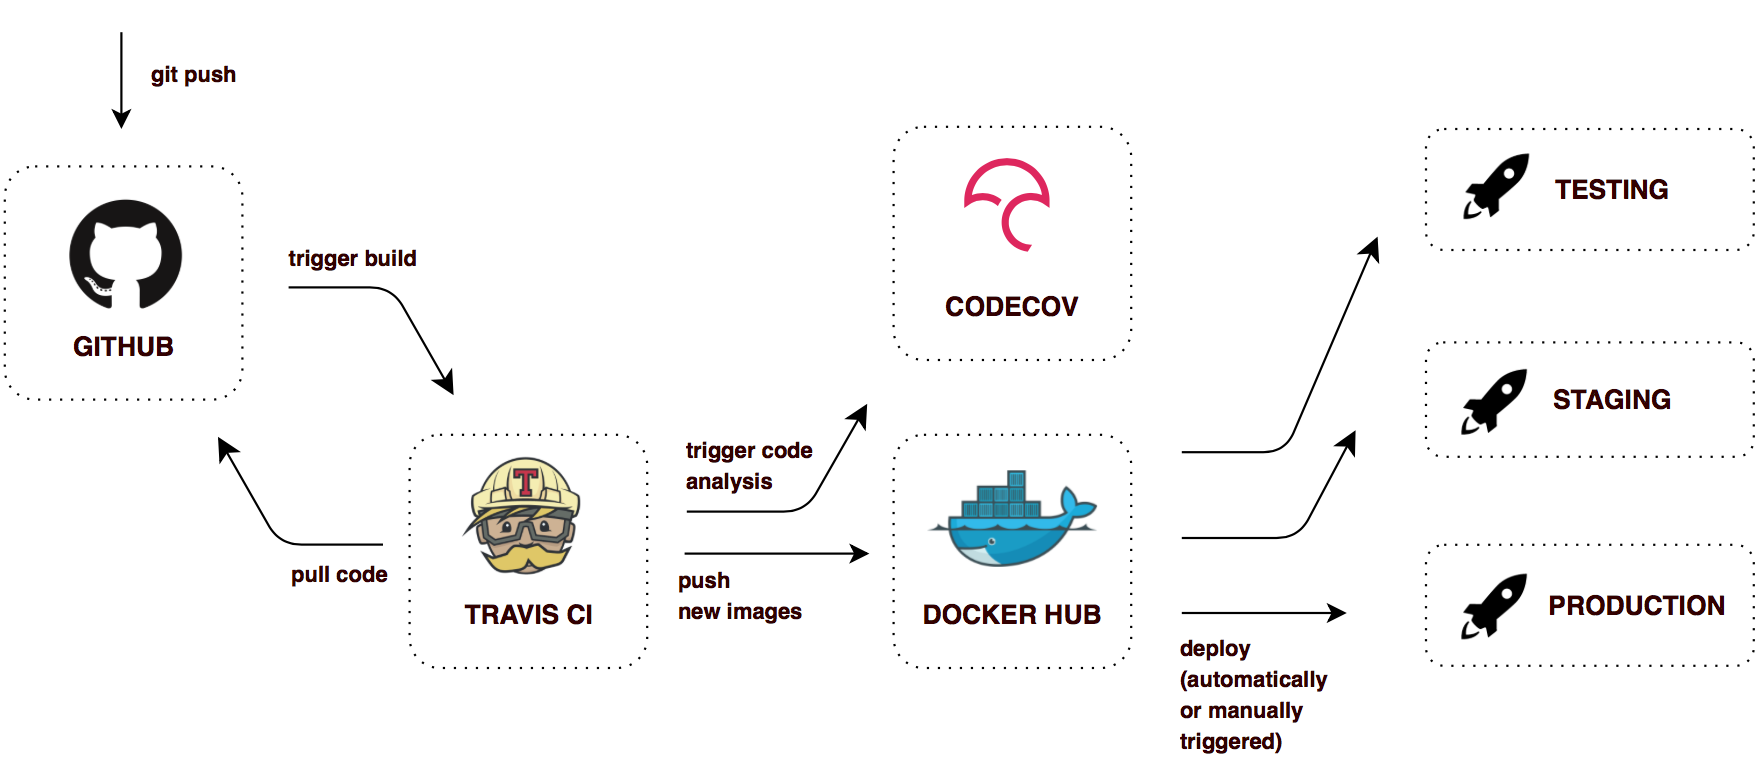 在此配置中,Travis CI 为每个成功的 git 推送构建标记图像。 因此,Docker Hub 上的每个微服务总是有最新的镜像和更旧的镜像,用 git commit hash 标记。 如果需要,部署它们中的任何一个并快速回滚都很容易。